#llm
25 публикаций
GamePause: инструмент для автоматического освобождения VRAM при игре
🚀 Играете на ПК и используете локальные LLMs? Теперь это не проблема! GamePause автоматически освобождает VRAM при запус...

0.8B модель победила 2B модель на ARC-Challenge с DynamicTune
🛠 Модель с 0.8B параметрами неожиданно обошла 2.5B модель, показав 42.15% на ARC-Challenge! Это стало возможным благодар...
BitRun: Быстрый и легкий запуск 1-битных LLM на любом компьютере
🚀 BitRun позволяет запускать 1-битные LLM на обычных ноутбуках, достигая скорости 98-127 токенов в секунду на Apple M4 P...
Проверка скорости локальных LLM перед покупкой GPU
🚀 Успех в тестах! Новый сайт позволяет оценить, насколько быстро работает локальная LLM, прежде чем вы решите инвестиров...

InferBench тестирует LLM на понимание приоритетов пользователя
🛠 В новой работе исследователи протестировали 12 моделей LLM, включая MiMo V2.6 Pro и GPT-6 Astra, на их способности пон...
Интерактивная симуляция с LLM-агентами в 3D мире
🚀 Мечтали увидеть, как LLM-агенты взаимодействуют в реальном времени? Проект Pantheon превращает эту мечту в реальность...
Новый бенчмарк для LLM — CatBench
🧪 Что, если бы существовал бенчмарк для языковых моделей, который был бы не только безопаснее, но и милее? Представляем ...
Сравнение 24 LLM с человеческими писателями по 475 запросам
🧪 Вышел первый релиз Creative Writing benchmark, в котором сравнили 24 LLM с человеческими писателями по 475 творческим ...
Shunt: Прокси для Claude Code с маршрутизацией
📦 Shunt — это прозрачный прокси для Claude Code, который позволяет маршрутизировать запросы к другим провайдерам LLM, со...
CPU-native LLM архитектура с производительностью 100+ токенов в секунду
🛠 113-130 токенов в секунду на модели с 10B параметрами! Это результат работы над архитектурой, оптимизированной для раб...

Neovim AI помощник для программирования с LLM
📦 CodeCompanion — это AI помощник для Neovim, который работает с LLM и различными агентами, такими как Claude Code и Git...
Бенчмаркинг оценки калорий с использованием LLM
🧪 В эксперименте по оценке калорий разработчик использовал LLM для анализа фотографий блюд и их описаний. Бенчмаркинг пр...
Инструмент для запуска LLM в песочнице и снижения токенов
🚀 Инструмент CodeTree индексирует ваш код в формате, который занимает всего 5% от оригинального размера. Это позволяет ...
Новый LLM Spark-X2.5 с уникальной архитектурой
🛠 Новая модель Spark-X2.5 представлена в версиях 4B и 1.7B. Она имеет уникальную архитектуру, а не просто является дообу...
Конструктор LLM-шлюза с поддержкой нескольких лабораторий
📡 Что, если вам не нужно быть привязанным к одной лаборатории для работы с LLM? Conifer — это новый LLM-шлюз, который пр...
Gonka: сеть для GPU, оплачивающая LLM-инференс
📡 Gonka запустилась на основной сети и предлагает уникальную возможность: сеть, которая оплачивает независимые GPU для в...
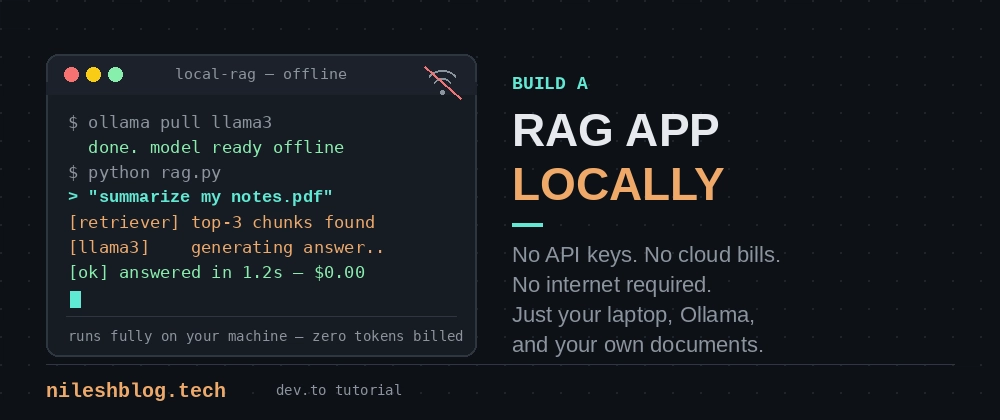
Как разработчик создал локальное RAG-приложение без API OpenAI
🚀 Спустя несколько недель мучительных расходов на API, разработчик решил кардинально изменить подход и создать Retrieval...
Запуск локальных LLM на Intel NPU с OpenVINO
🚀 Разработан OpenVINO Windows LLM, который упрощает запуск локальных моделей на Intel NPU на Windows! Этот проект объед...

Как PDFs уничтожают токены вашего LLM и как это исправить
📡 Загружая PDF в AI-чат, можно неожиданно сжечь свой токен-бюджет — страница может стоить от 1,500 до 3,000 токенов. Но ...

llm-wiki-memory: локальная память для AI-агентов
📦 Представляем llm-wiki-memory — локальную память для AI-кодеров, которая полностью работает без RAG и облачных сервисов...